

#新动态 #前端 #工程化 #开源 #AI
好久没看大佬们的 blog 了让我康康都有什么更新:
🧩 Devframe:可插拔、可扩展的 DevTools
antfu 推出框架无关的 DevTools 基础框架:工具定义一次,通过适配器接入不同宿主,减少通信、状态同步、资源托管等重复建设,试图让 DevTools 从“各框架重复造轮子”,走向共享插件生态。
• 同一套定义可用于独立 CLI、开发服务器、Vite DevTools 插件、MCP Server 或静态报告。
• 同时面向开发者与 AI Agent:可视化界面用于查看和交互,MCP 接口让 Agent 访问工具能力。
• 内置数据检查器、终端、无障碍检查器等插件,让通用能力跨框架复用。
• 已用于 Vite DevTools、Nuxt DevTools 等工具;Next.js DevTools 仍处于原型阶段,并非所有设想中的集成都已落地。
不好意思啦~我确实是转区成功啦!我也确实顺利晋级啦~
然后我之后还会继续美美打Major,继续在自己喜欢的赛区拿贴纸。
至于Sashi,我想晋级会很困难吧。可能会想努力申请亚洲的赛区?不管是哪个赛区都会收到我的证据材料❤️
至于Sashi,是偷贴纸的吧,之后还会想转区的吧(不好意思我已经转区成功啦),我会继续神权的,希望他能顺利晋级(但我想会很难)
然后我之后还会继续美美打Major,继续在自己喜欢的赛区拿贴纸。
至于Sashi,我想晋级会很困难吧。可能会想努力申请亚洲的赛区?不管是哪个赛区都会收到我的证据材料❤️
至于Sashi,是偷贴纸的吧,之后还会想转区的吧(不好意思我已经转区成功啦),我会继续神权的,希望他能顺利晋级(但我想会很难)
https://www.hltv.org/news/45666/valve-issues-exception-for-bcgame-to-qualify-for-singapore-major-through-asia
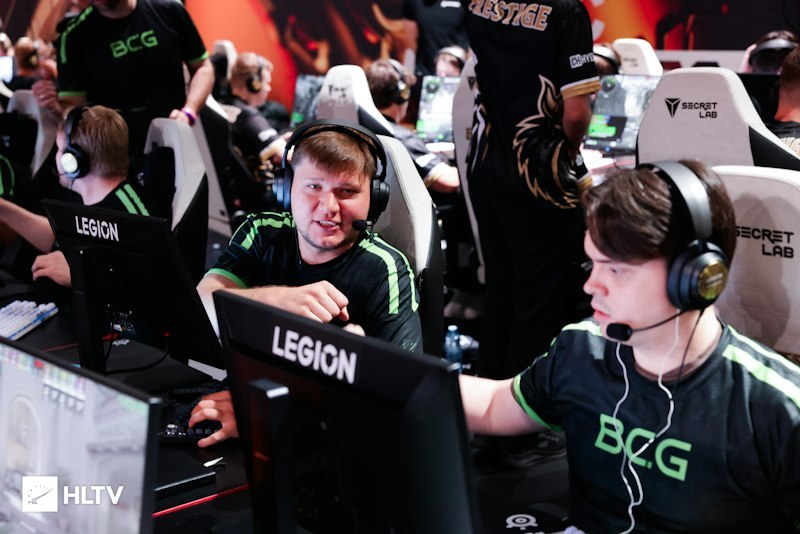
合理怀疑 CS2 项目组是不是被指控赌博后缺流水了,迫切地想要拉个 s1mple 回来分贴纸流水😇
前情提要:
s1mple 所在的 BC.Game 打欧洲区比赛翻车失去了进入 Major 的可能性,于是紧急拉了一个亚洲人过来,凑齐了三个亚洲人想要转亚洲赛区抢名额(Major 的邀请资格是按每个地区独立排名),并由此掀起了列强外区战队如Sashi瓜分亚洲赛区名额的狂潮。
然后在昨天,V社针对 Major 发布了补充规则,大意是如果一支队伍在过去的三个日历月(calendar months)内曾出现在其他任何地区的VRS榜单中,那么他们现在将不再具有进行赛区转换的资格,换句话说就是,如上队伍在进入邀请窗口前的临时变阵行为失效,任何变阵都必须要三个月才能拥有被邀请的资格。到这个时间段为止 BCG 和 Sashi 的参赛计划可以宣告破产。
然后在刚刚,V社在 GitHub 签发了一条例外豁免,允许 s1mple 所在的 BCG 转换到亚洲赛区并具备获得直邀资格的条件。(具备条件,而非已经获得直邀资格,因为目前尚未到前述的邀请窗口,积分排名尚未冻结)
缇宝抢走了豆姐的工作!但谁不想给车机 root 了再装一个更聪明的助手呢?😎
https://www.bilibili.com/video/BV1Ctpu6sEbN/
Tibo 都要连夜注册个 b 站号给群友点赞
https://www.bilibili.com/video/BV1Ctpu6sEbN/
https://play.google.com/store/apps/details?id=com.catchingnow.andfiles.helper
使用shizuku/adb的桌面模式app,可以在电脑上以桌面模式打开手机上的app,还支持终端、文件传输和投屏等。客户端仅原生支持Mac,Windows和Linux只能通过浏览器打开网页使用。网站位于公网,不能仅局域网使用。
使用shizuku/adb的桌面模式app,可以在电脑上以桌面模式打开手机上的app,还支持终端、文件传输和投屏等。客户端仅原生支持Mac,Windows和Linux只能通过浏览器打开网页使用。网站位于公网,不能仅局域网使用。
有一天,公司决定重构十年前留下来的核心系统。
技术总监在会上只提了一个要求:「新架构一定不能有单点故障(Single Point of Failure,SPOF)。」资深工程师点点头。「明白。」
于是,原本只有一台服务器、一个数据库、一套程序的系统,正式开始现代化改造。第一个月,团队把单体架构(Monolithic Architecture)拆成了微服务架构(Microservices Architecture)。
原本一套程序,变成了四十七个服务。
用户登录有 Authentication Service,权限验证有 Authorization Service,用户资料有 User Service,订单有 Order Service,支付有 Payment Service,通知有 Notification Service。
甚至连「获取用户名」这样一件小事,也需要经过 API Gateway 调用 User Service。
领导看完架构图,非常满意。
「很好。这样任何一个服务挂了,都不会影响整个系统。」
工程师没有回答。
因为他正在思考:如果 Authentication Service 挂了,用户到底要怎么进去使用那些「没有受到影响」的服务。
第二个月,架构师认为服务之间直接相互调用,耦合度太高。
于是引入了 Kafka。
大家开始谈论事件驱动架构(Event-Driven Architecture)。
OrderCreated。
PaymentCompleted。
InventoryReserved。
ShipmentCreated。
每件事情都变成了一个 Event。
以前,工程师想知道「订单为什么没有发货」,查一下数据库就行。
现在要先问:
「你知道这笔订单的 Correlation ID 吗?」
不知道。
「那 Trace ID 呢?」
也不知道。
「Message Key 呢?」
没有。
「Partition 呢?」
不知道。
工程师沉默了三秒。
「那我们从 Kafka 第一个 Offset 开始找吧。」
第三个月,大家发现四十七个服务部署起来实在太麻烦。于是引入 Kubernetes,简称 K8s。
从此,公司的技术文档里开始出现许多以前没人用过的单词:
Pod。
Deployment。
ReplicaSet。
Service。
Ingress。
ConfigMap。
Secret。
Namespace。
StatefulSet。
DaemonSet。
领导看到 Replica 设置成 3,非常安心。
「很好,同一个服务有三份,就算挂一个也没问题。」
结果三个 Pod 全跑在同一台 Node 上。那台 Node 一挂,三个 Replica 一起消失。
架构师看了一眼 YAML。
「没关系,我们加 Pod Anti-Affinity。」
第二天,Kubernetes Scheduler 因为条件设得太严格,一个 Pod 都调度不上去。
领导问:「所以现在有几个 Replica?」
工程师回答:「理论上三个。」
「实际上呢?」
「零个。」
第四个月,系统开始变慢。
团队决定引入 Redis 做缓存(Cache)。
原本查一次数据库需要 200 ms。
加了 Redis 之后,只需要 5 ms。
所有人都非常高兴。
直到有一天,有人修改了用户资料。
数据库里是新的。
Redis 里是旧的。
另一个服务自己的 Local Cache 里又是更旧的。
领导问:
「到底哪份数据是真的?」
后端工程师回答:
「要看你问的是哪台。」
于是,团队开了三个小时的会,专门讨论 Cache Invalidation。
会议最后的结论是:
「先把 TTL 设成五分钟。」
第五个月,因为系统已经有四十七个服务,大家开始不知道错误究竟发生在哪里。于是引入了一整套可观测性(Observability)系统。
Prometheus 收 Metrics。
Grafana 画 Dashboard。
Loki 收 Logs。
Jaeger 做 Distributed Tracing。
Alertmanager 发告警。
现在,系统只要慢 100 ms,Grafana 上就有十五张图一起变色。
领导看着满墙的监控大屏,非常感动。「我们现在是不是什么问题都能看到了?」
SRE 回答:
「看得到。」
「那问题在哪?」
「不知道。」
「那这些图是干什么的?」
「证明真的有问题。」
第六个月,公司要求做到高可用(High Availability,HA)。
于是数据库做 Primary-Replica。
Redis 做 Cluster。
Kafka 做 Cluster。
Kubernetes 做 Multi-Node。
Ingress 做 Load Balancing。
机房做双线路。
服务跨 Availability Zone 部署。
技术总监再次强调:「我们绝对不能有任何单点故障。」
大家花了半年,把所有看得见的 Single Point of Failure 全部消灭。
最后,整个系统拥有:
47 个 Microservices。
186 个 Pods。
12 台 Kubernetes Nodes。
9 台 Kafka Brokers。
6 台 Redis Nodes。
4 台 Database Servers。
3 组 Load Balancers。
2 个 Availability Zones。
完整的 CI/CD Pipeline。
完整的 Monitoring。
完整的 Distributed Tracing。
完整的 Auto Scaling。
架构文档有两百多页。技术总监非常满意。
正式上线那天,他站在办公室里宣布:「各位,经过半年的努力,我们终于做出了一个没有单点故障的系统。」
全公司鼓掌。
五分钟后。
整个系统全挂了。
不是某一个服务。不是某一个机房。也不是某个 Database。而是所有服务同时失联。
技术总监冲进机房:「Kubernetes 挂了吗?」
「没有。」
「Kafka?」
「正常。」
「Database?」
「正常。」
「Redis?」
「正常。」
「Load Balancer?」
「正常。」
「网络呢?」
「也正常。」
技术总监更紧张了。「那到底哪里坏了?」
资深工程师看着屏幕,沉默了很久。
然后说:
「DNS。」
原来早上有人修改 DNS 配置时,多敲了一个字符。
所有服务其实都还在正常运行。
所有 Pod 都是 Healthy。
所有 Database 都是 Healthy。
Kafka 没有任何异常。
Redis Cluster 完全正常。
CPU 使用率正常。
Memory 正常。
Network 正常。
只有一个小问题:大家找不到彼此。
技术总监看着那份号称「完全没有 Single Point of Failure」的两百页架构文档,问了一句:
「我们不是已经把所有单点故障都消除了吗?」
资深工程师想了想。
「没有。」
「还有什么?」
工程师指了指 DNS。
「我们只是把单点故障藏得更深了。」
会议室安静了十秒。
技术总监又问:
「那 DNS 可以做高可用吗?」
工程师回答:
「可以。」
「那就做。」
一年后,公司拥有了两套 DNS、三层 Load Balancer、两个 Kubernetes Cluster、跨区 Kafka、跨区 Database Replication,以及一套连原作者自己都不敢改的 Terraform。
技术总监再次召开会议。
「现在总没有单点故障了吧?」
这一次,没有人回答。
因为上周,唯一知道整套架构究竟如何运作的那位资深工程师离职了。
技术总监环顾会议室。
「文档呢?」
有人回答:
「有。」
「在哪?」
「公司的 GitLab。」
「很好,那打开。」
工程师操作了一下。
「打不开。」
「为什么?」
「GitLab 的 SSO(Single Sign-On)依赖公司的 Authentication Service。」
技术总监停顿了一下。
「那 Authentication Service 怎么修?」
「部署方法写在 GitLab 里。」
「那 GitLab 怎么修?」
「Kubernetes 的配置也在 GitLab 里。」
「那 Kubernetes 呢?」
「Terraform。」
「Terraform 在哪?」
「GitLab。」
整个会议室再次安静下来。
最后,新来的工程师小心翼翼地问:「所以现在真正的 Single Point of Failure 是什么?」
所有人不约而同地看向资深工程师原来的位置。
桌子已经空了。
旁边只剩下一张便利贴。
上面写着:
「如果你需要看这张纸,说明 Disaster Recovery Plan 已经失败了。」
技术总监看完之后,沉默了很久。
最后,在下一季度的技术战略汇报中,新增了一页:
「2027 年核心架构改进计划」
第一项:「降低 Bus Factor。」
第二项:「建立完整的 Knowledge Transfer 机制。」
第三项:「不要再让所有文档的登录方式,依赖一个只有登录文档之后才能知道怎么修的登录系统。」
「在分布式系统里,真正困难的不是让每一台机器都不会坏,而是当每一台机器都正常的时候,找出为什么整个系统还是不能用。」
投稿日期:2026 年 10 月 4 日 17:30(CST)
